「山田太郎」を1文字ずつ数えて姓と名に分けるのをやめた日
氏名を姓と名の2列に分ける関数を作ったら、スペースの無い名前だけがうまくいかなかった。1文字ずつ数えて切れ目を探していた作業と、そこから作ったツールの話を書く。
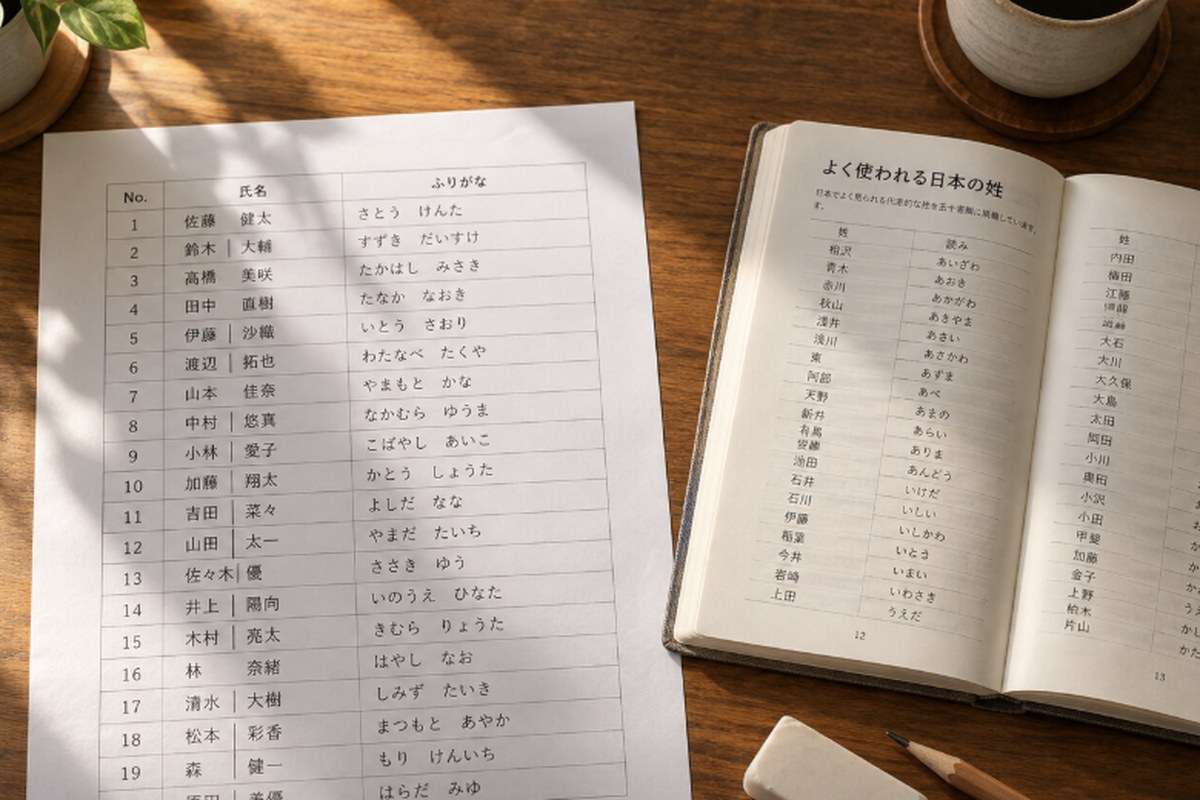
「山田 太郎」はできたが、「山田太郎」で止まった
届いた名簿の氏名を、姓と名の2列に分ける必要があった。多くの行は「山田 太郎」のように姓と名の間にスペースがあり、スペースの位置を探す関数ですぐに分けられた。
=LEFT(A2,FIND(" ",A2)-1)
ところが名簿の3割ほどは「山田太郎」のようにスペースが無い状態だった。スペースを探す関数は、スペースが無い文字列に対してエラーを返す。この行だけ、結果が全部エラーになった。
姓は何文字か、機械には分からない
スペースが無い名前をどう分けるか考えて、最初に思いついたのは「姓は2文字」という決めつけだった。日本人の姓は2文字が多い、という印象からの発想だった。
実際に試すと、次のような名前で崩れた。
- 「佐々木太郎」——姓は3文字。2文字で切ると「佐々」と「木太郎」になる。
- 「林太郎」——姓は1文字。2文字で切ると「林太」と「郎」になる。
- 「小鳥遊次郎」——姓が4文字の場合もある。
姓の文字数は、名前によってばらばらだった。結局、こうした名前だけを1件ずつ、姓が何文字かを判断しながら手で分ける作業が残った。
気づいたのは「姓の一覧と照らし合わせるしかない」ことだった
住所の分割で「実在する市区町村名の一覧と照らし合わせる」方式にたどり着いたのと同じように、氏名の分割にも同じ発想が使えることに気づいた。
日本の姓は数が多いとはいえ、有限の一覧として存在する。よくある姓の一覧を持っておき、氏名の先頭からいちばん長く一致する姓を探せば、スペースが無い名前でも姓の切れ目が分かる。「佐々木」も「小鳥遊」も、一覧にあれば正しく切り出せる。
ここで書いたツールを、実際に試す
氏名を姓と名に分けるツールを開く実際にどう動くか
氏名のリストを貼り付けると、スペースがあればスペースで、無ければ姓の辞書と照合して分ける。
| 貼り付けた氏名 | 分割結果 | 判定 |
|---|---|---|
| 山田 太郎 | 山田 / 太郎 | 確実(スペースあり) |
| 佐々木太郎 | 佐々木 / 太郎 | 辞書と一致 |
| 林太郎 | 林 / 太郎 | 要確認(1文字姓) |
| 東山紀之 | 東 / 山紀之 | 要確認(辞書外の可能性) |
1文字姓は、確認の印を付けて出す
「林」「木」のような1文字の姓は、名の1文字目と見分けがつきにくい。このツールは、1文字姓・辞書に無い姓・名が1文字だけの行を「要確認」として表示し、機械が自信を持てない行を隠さないようにしている。
作ってみて変わったこと
スペースの有無で処理を分ける必要がなくなった。名簿の入力元によってスペースが有ったり無かったりする状態でも、1回の貼り付けで済むようになった。
もう1つ気づいたのは、この作業を代わりにやってくれる人に頼むのが難しかったということだ。「2文字で切って、おかしければ直して」という説明では、何をもって「おかしい」と判断するのかが伝わらない。今は「要確認の印が付いた行だけ見て」と伝えられるので、作業の切り分けそのものがやりやすくなった。
使うときの注意
姓の辞書は、一般的な姓を中心に作っている。地域によって多い姓、外国にルーツのある名前、通称名のように辞書に載りにくいものは、要確認として扱われる。分割の結果をそのまま宛名や公式書類に使う前には、必ず元の氏名と見比べる工程を挟んでいる。
よくある質問
珍しい姓は正しく分けられますか?
辞書に無い姓は「要確認」として表示されます。辞書は一般的な姓を中心にしているため、珍しい姓は確認が必要な行として出てきます。
全角・半角スペースが混ざっていても大丈夫ですか?
大丈夫です。どちらのスペースも区切りとして認識します。スペースの統一だけを行うモードもあります。
ふりがなも一緒に分けられますか?
氏名の分割位置に合わせて、ふりがなの列も同じ位置で分けることができます。
会社名など、人名でないものが混ざっていたら?
辞書に一致する姓が見つからない文字列として扱われ、要確認の一覧に出ます。人名以外のデータが混ざっている名簿でも、気づかず処理してしまうことは避けられます。
関連する読みもの・ツール
同じように、自分の手作業をツールにしたものを他にも置いています
kamitoolはゲームや事務仕事の細かいツールが中心ですが、ネットショップの在庫・利益管理や、モール間のデータ移行のようなものは、noteで「TOOL BOX|手作業をツールにする」として公開しています。オフラインで動くファイル1枚の形で配っているものもあります。